生成式AI的浪潮尚未结束,计算产业已经开始迎接下一阶段——智能体AI。
与过去“输入问题、生成答案”的AI不同,智能体需要持续保持上下文,调用工具、访问数据库、运行应用,并根据环境变化作出决策。当这种智能从云端进入手机,再进入汽车、机器人和工业设备,计算系统面对的挑战也随之发生变化:AI不再只是某个 NPU 上运行的一段模型,而成为贯穿CPU、GPU、内存、互连、操作系统和软件框架的一种系统级工作负载。
在近日举行的Arm Everywhere China 2026 年度大会上,Arm 给出了自己的答案。Arm在此次峰会上,全面更新了其C2 CPU、Mali G2-Ultra NX GPU、第二代移动终端计算子系统 CSS for Mobile 2、向云端的Neoverse CSS N4、Arm AGI CPU,以及针对物理AI的Arm Total Design和机器人能力分级框架,此次更新,几乎覆盖了AI从“诞生、运行到行动”的整个链条。
从此次峰会宣布的产品、技术和市场信息来看,Arm正在试图把过去建立在CPU IP上的优势,扩展成为覆盖云、边缘和物理世界的统一AI计算平台。
从“NPU算力”转向系统级AI
这种变化首先发生在智能手机。
过去几年,手机厂商讨论AI性能时,几乎一致性都在强调算力达到了多少TOPS,且有不断提高NPU算力的趋势。但进入智能体时代后,单纯提升NPU峰值算力已经很难完整描述一台设备的AI能力。
因为智能体AI并不是一次性执行一个模型。它需要维护上下文、启动App、调用不同模型和服务,还需要协调多个计算引擎,因此,Arm把 CPU 定义为智能体系统中的“编排引擎”。
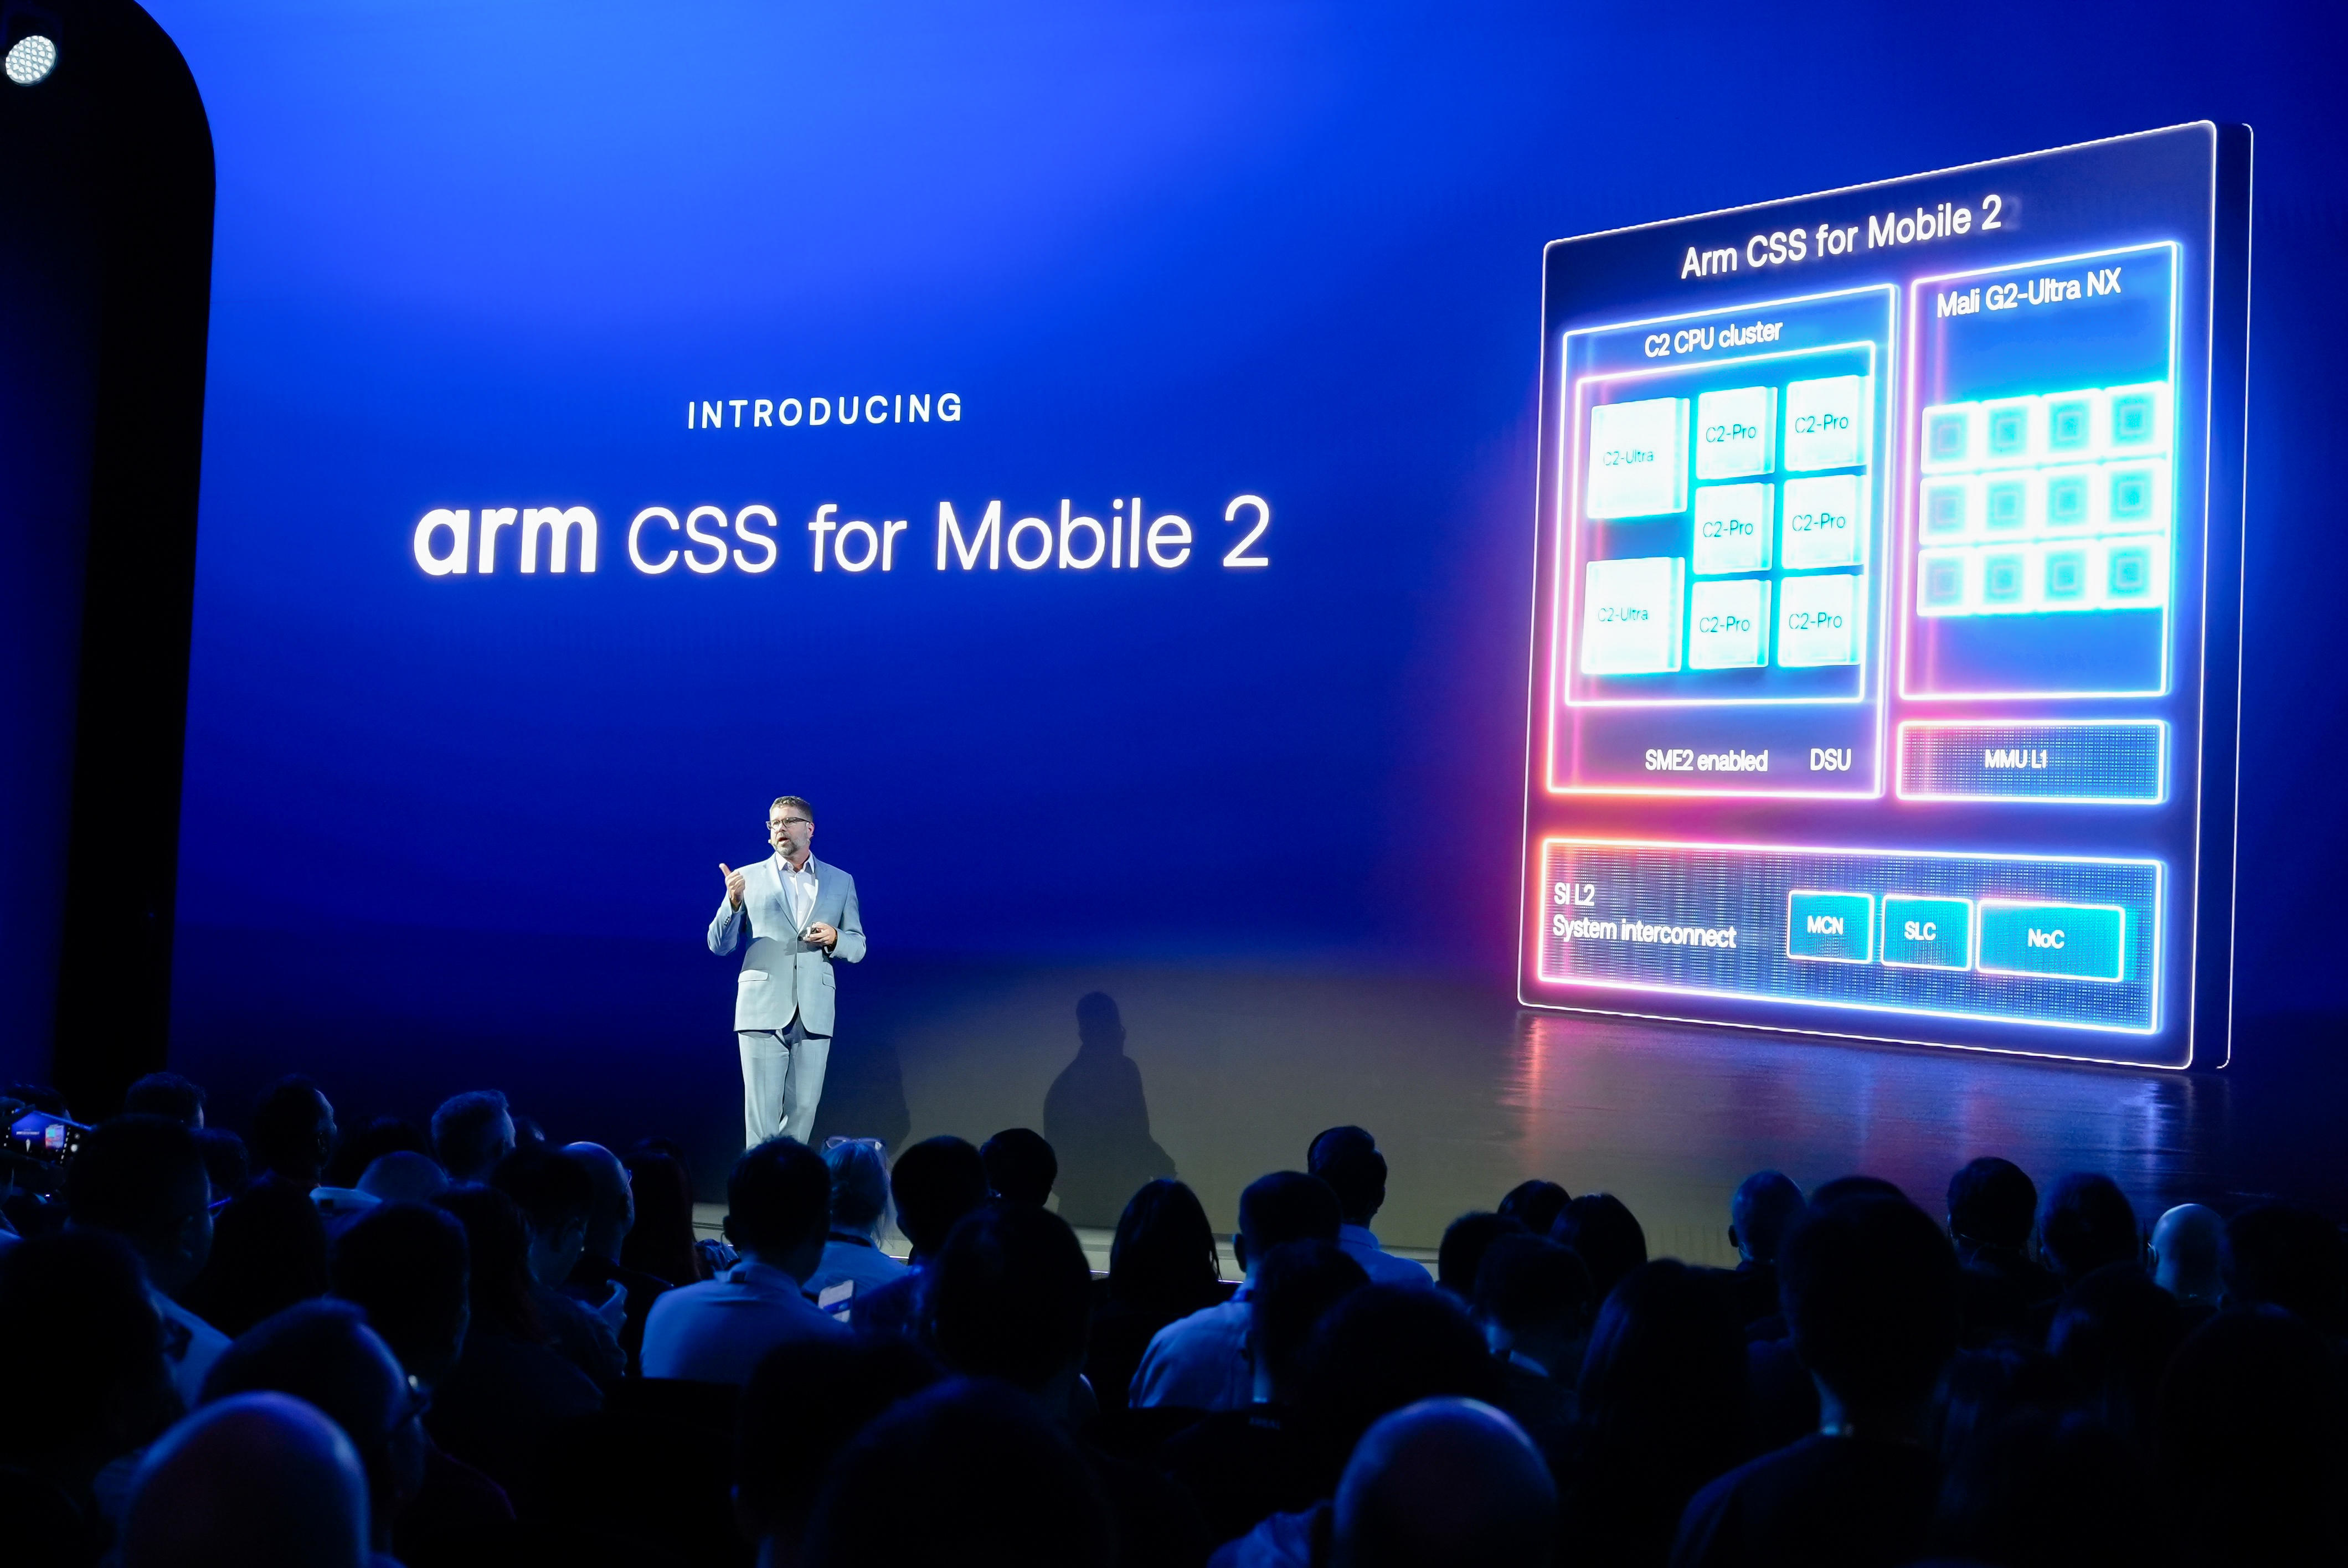
此次Arm发布的 CSS for Mobile 2,实际上正体现了这一思路。平台集成C2 CPU集群、Mali G2-Ultra NX GPU、增强型系统IP、物理实现方案及软件生态。其中,C2 CPU集群由 C2-Ultra、C2-Pro以及双SME2单元组成。
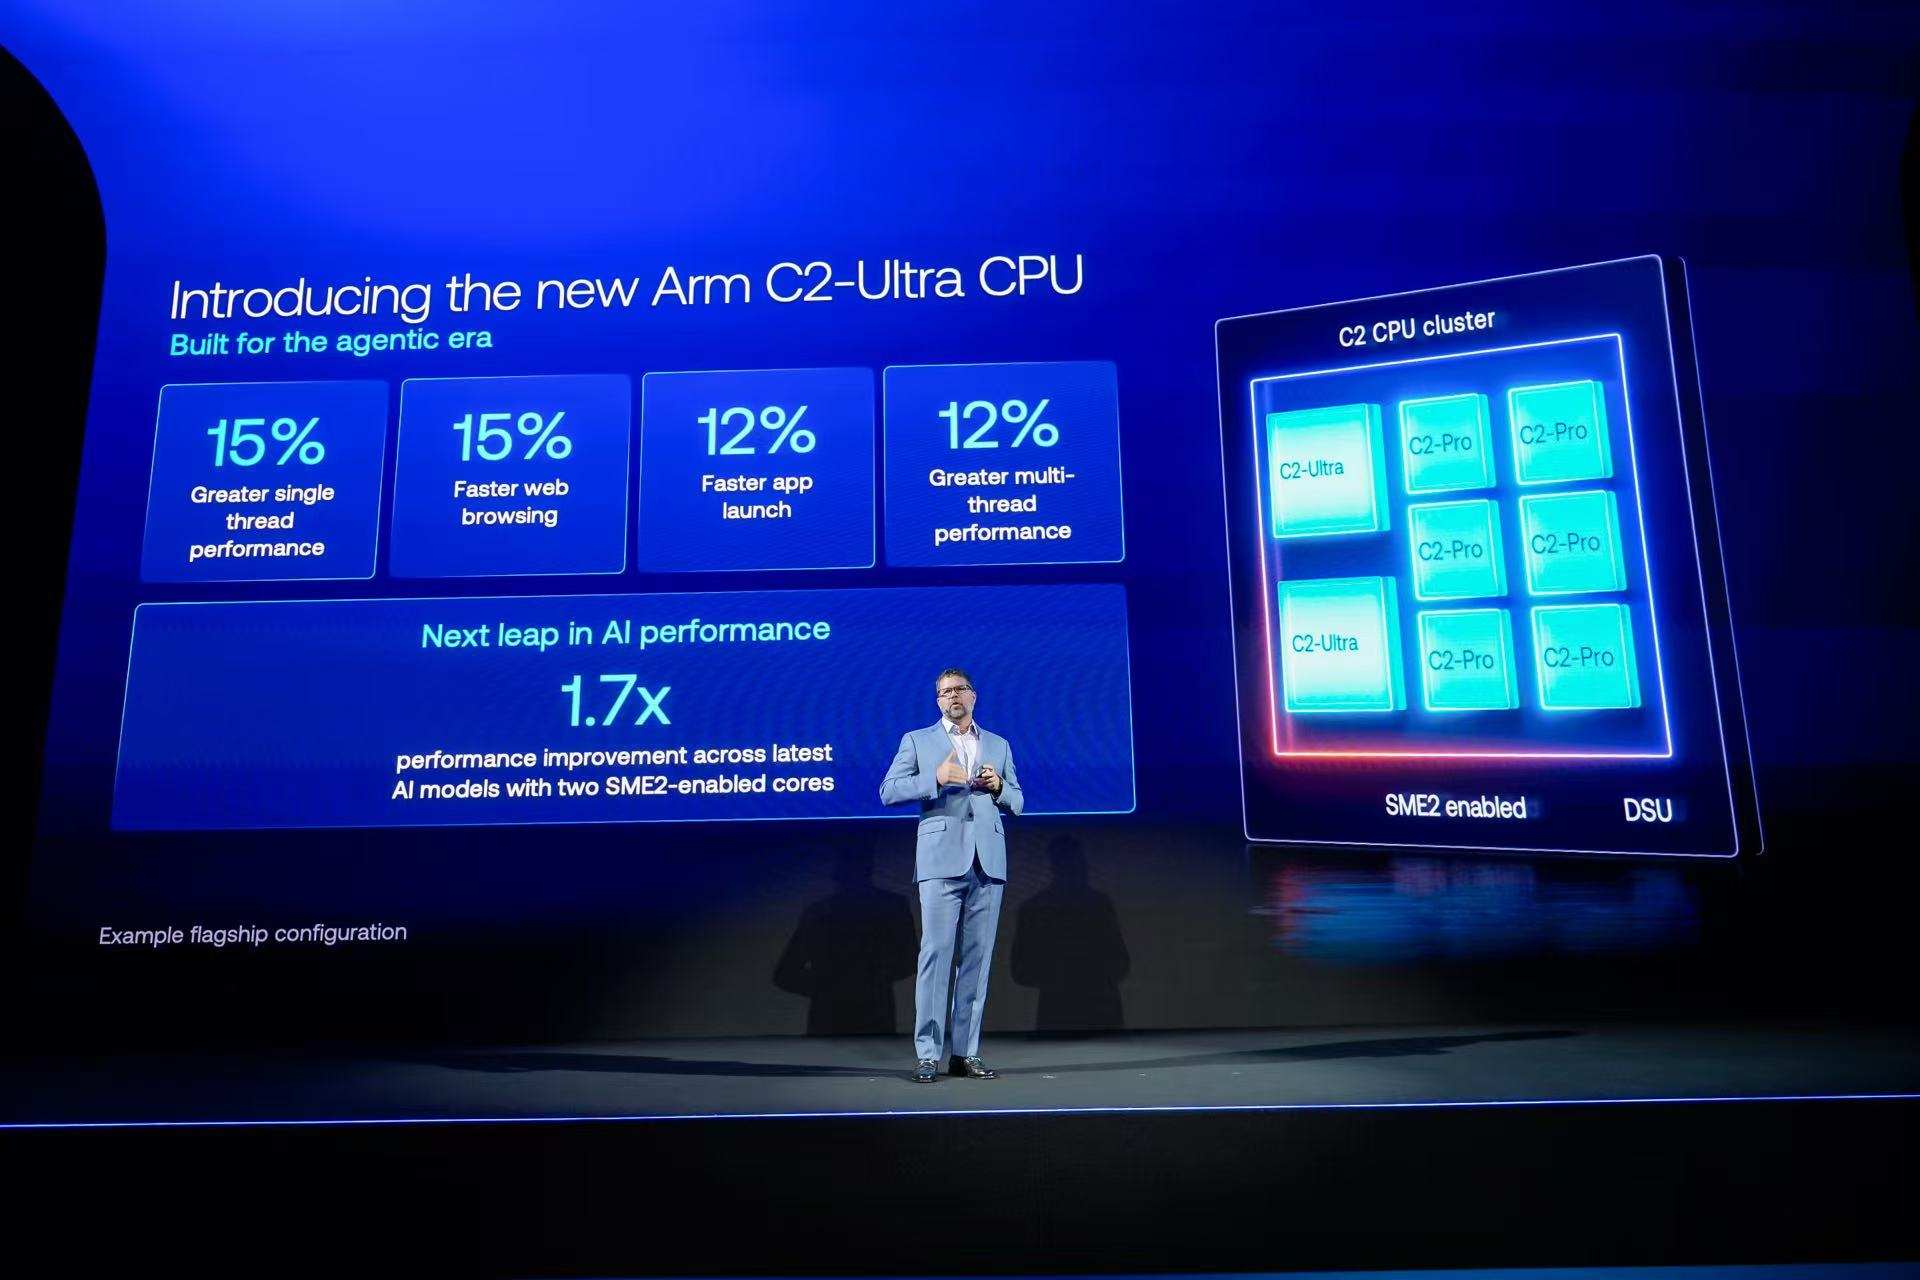
根据Arm的介绍,相比上一代C1-Ultra,C2-Ultra 单线程性能最高提升15%,AI性能最高达到1.7倍;在相同性能下,功耗最高可降低38%。双SME2计算能力则使部分小语言模型运行速度最高提升70%。
谈到将SME2放入CPU、神经网络加速器放入GPU,与不断提升NPU算力有何不同时,Arm对芯查查表示,首先是Arm 给出的答案首先是编程模型和调度方式。SME2可以像 CPU指令一样使用,因此具有较低延迟,也更容易进入现有CPU软件栈;GPU内的神经网络加速器,则可以与图形工作负载共享内存、缓存和调度体系。相比之下,不同厂商的NPU往往具有不同的编程和调度模式,开发者需要额外判断工作负载究竟应该运行在哪一种加速器上。
也就是说,Arm对边缘AI的策略是将CPU、GPU和AI加速单元、内存和软件真正协同起来,共同工作,而非单独依靠堆NPU算力。
AI开始进入GPU,移动图形迎来“神经化”
Arm另一个值得关注的变化是,正式把神经网络能力带入Mali GPU。
Mali G2-Ultra NX是首款集成专用神经网络加速器的Mali GPU。神经网络计算与传统图形处理能够在同一GPU管线中协同运行,同时增加新的执行引擎和第三代光线追踪单元。
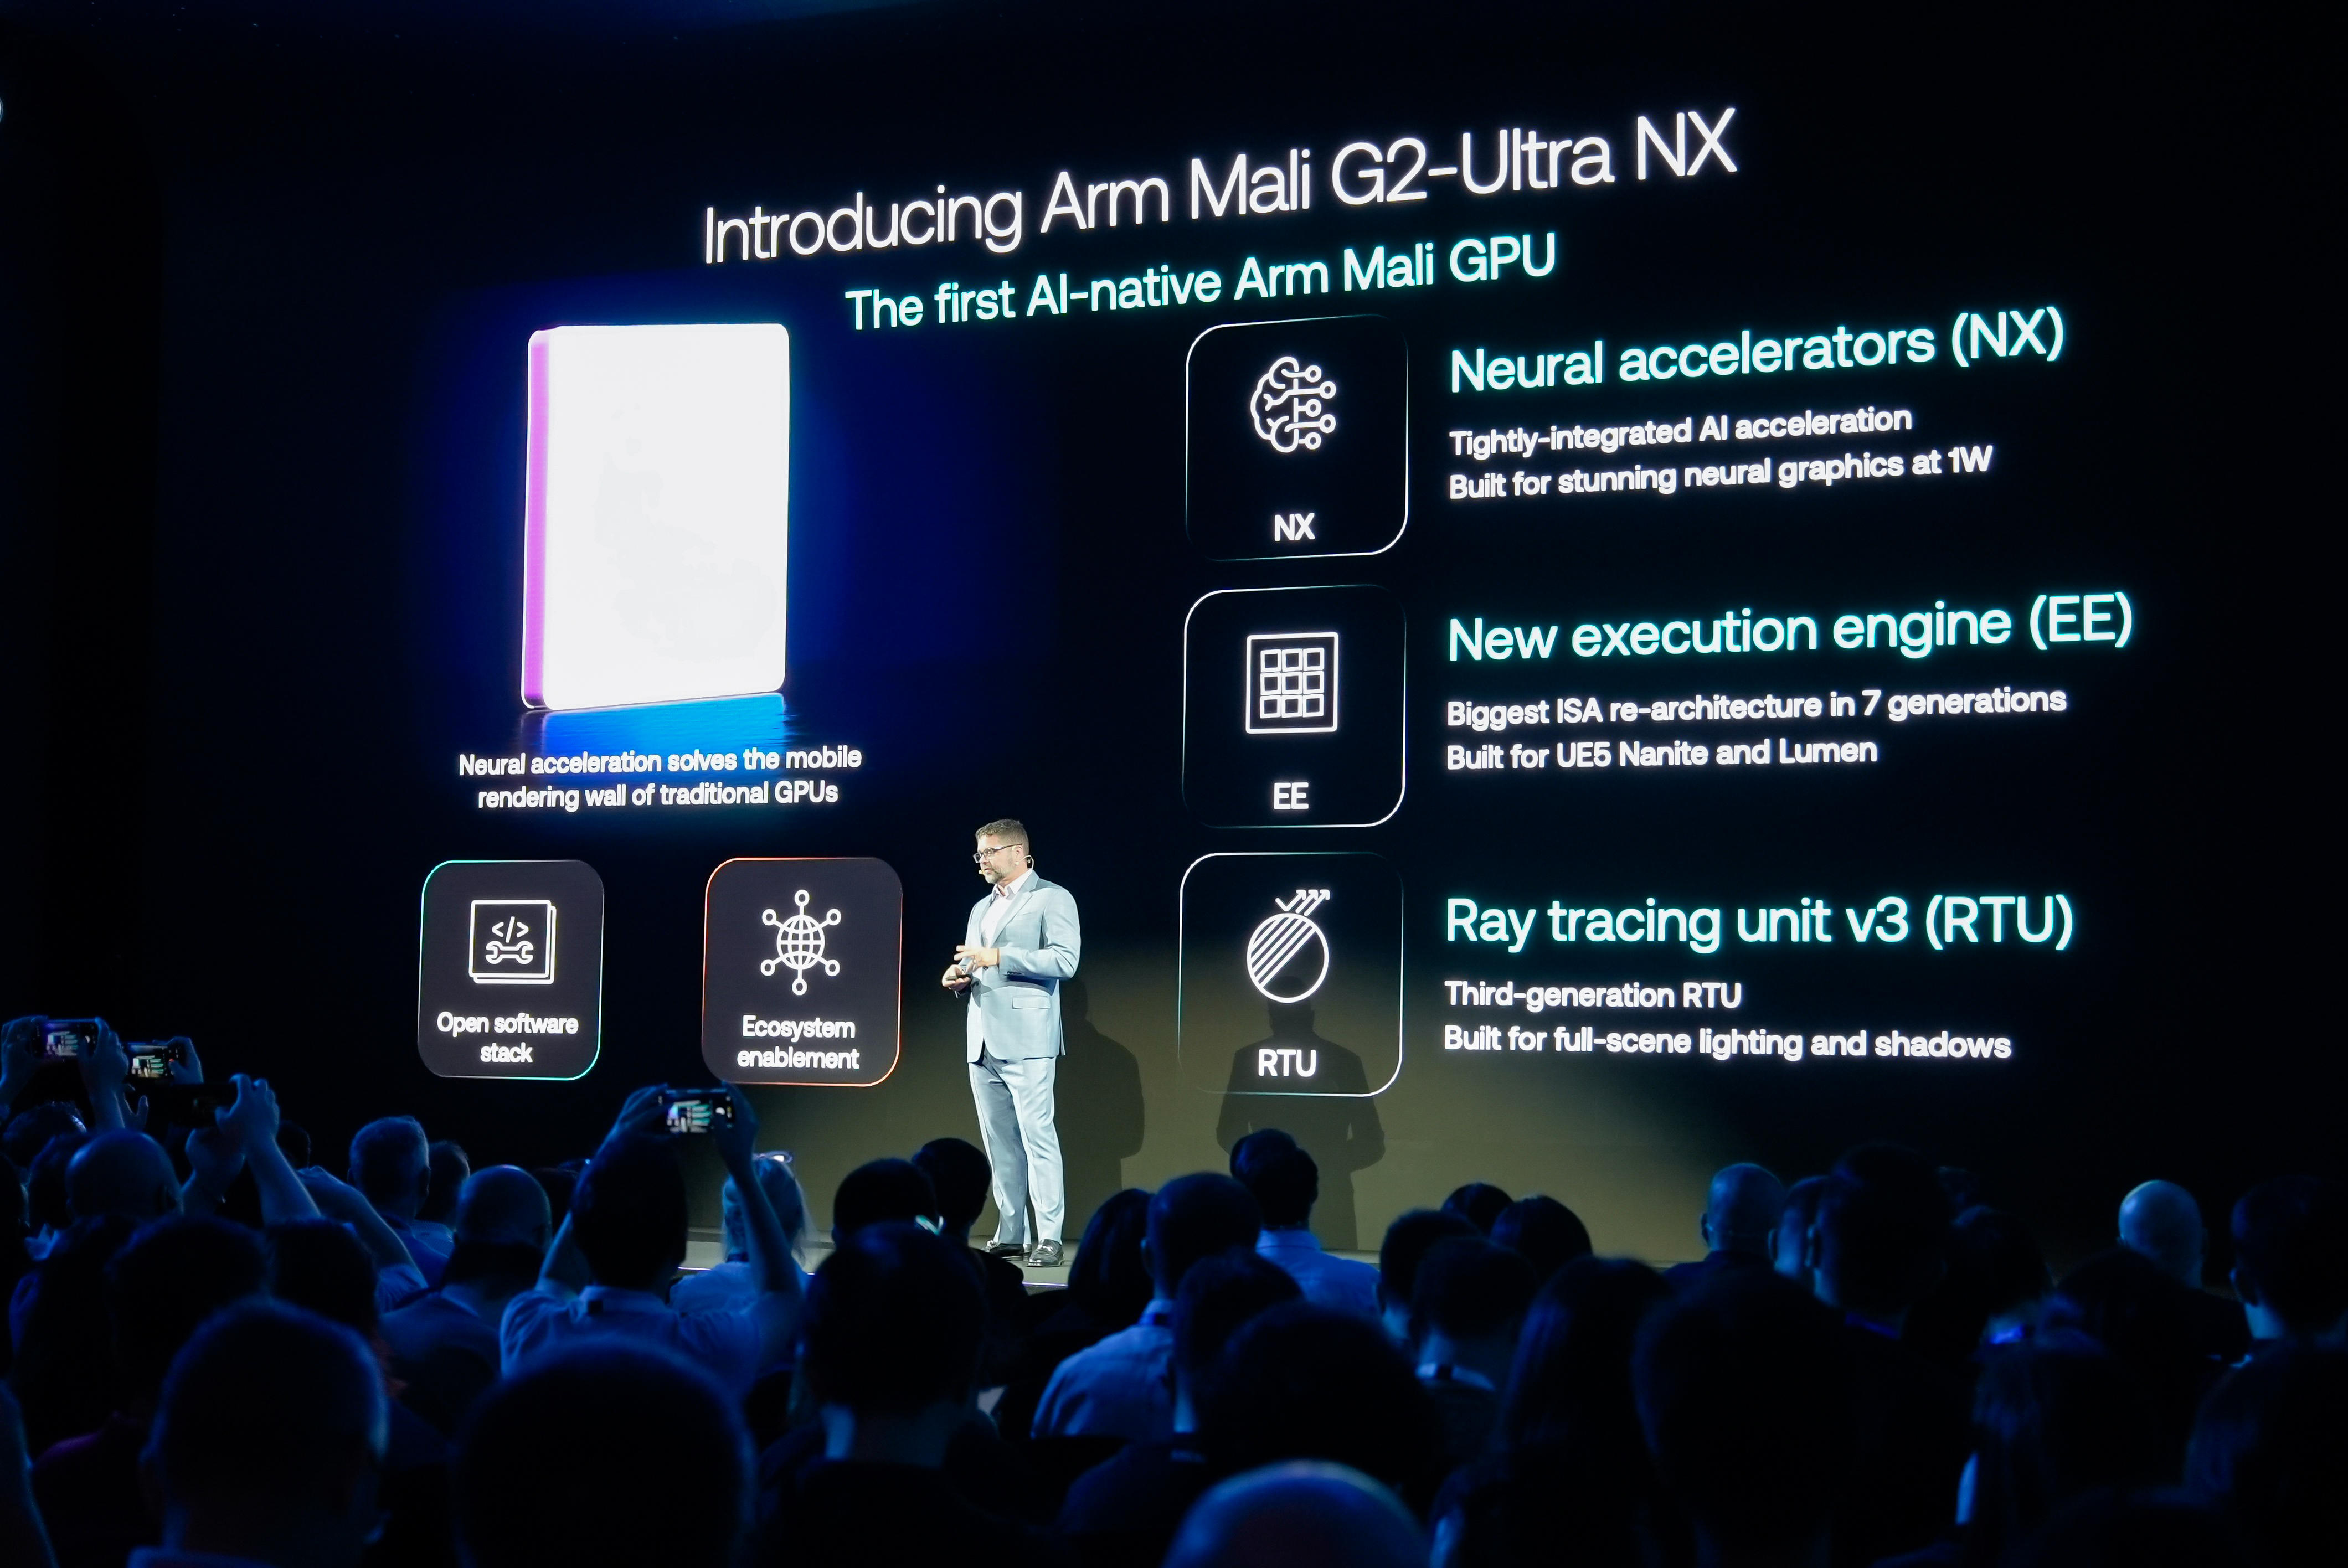
Arm在峰会上展示的数据显示,在神经网络处理场景下,其每瓦性能最高提升4倍;传统游戏性能相比上一代最高提高14%。
与过去依靠提高 GPU 算力“硬渲染”不同,越来越多图形处理正在转向“少算一部分,再通过AI重建”。
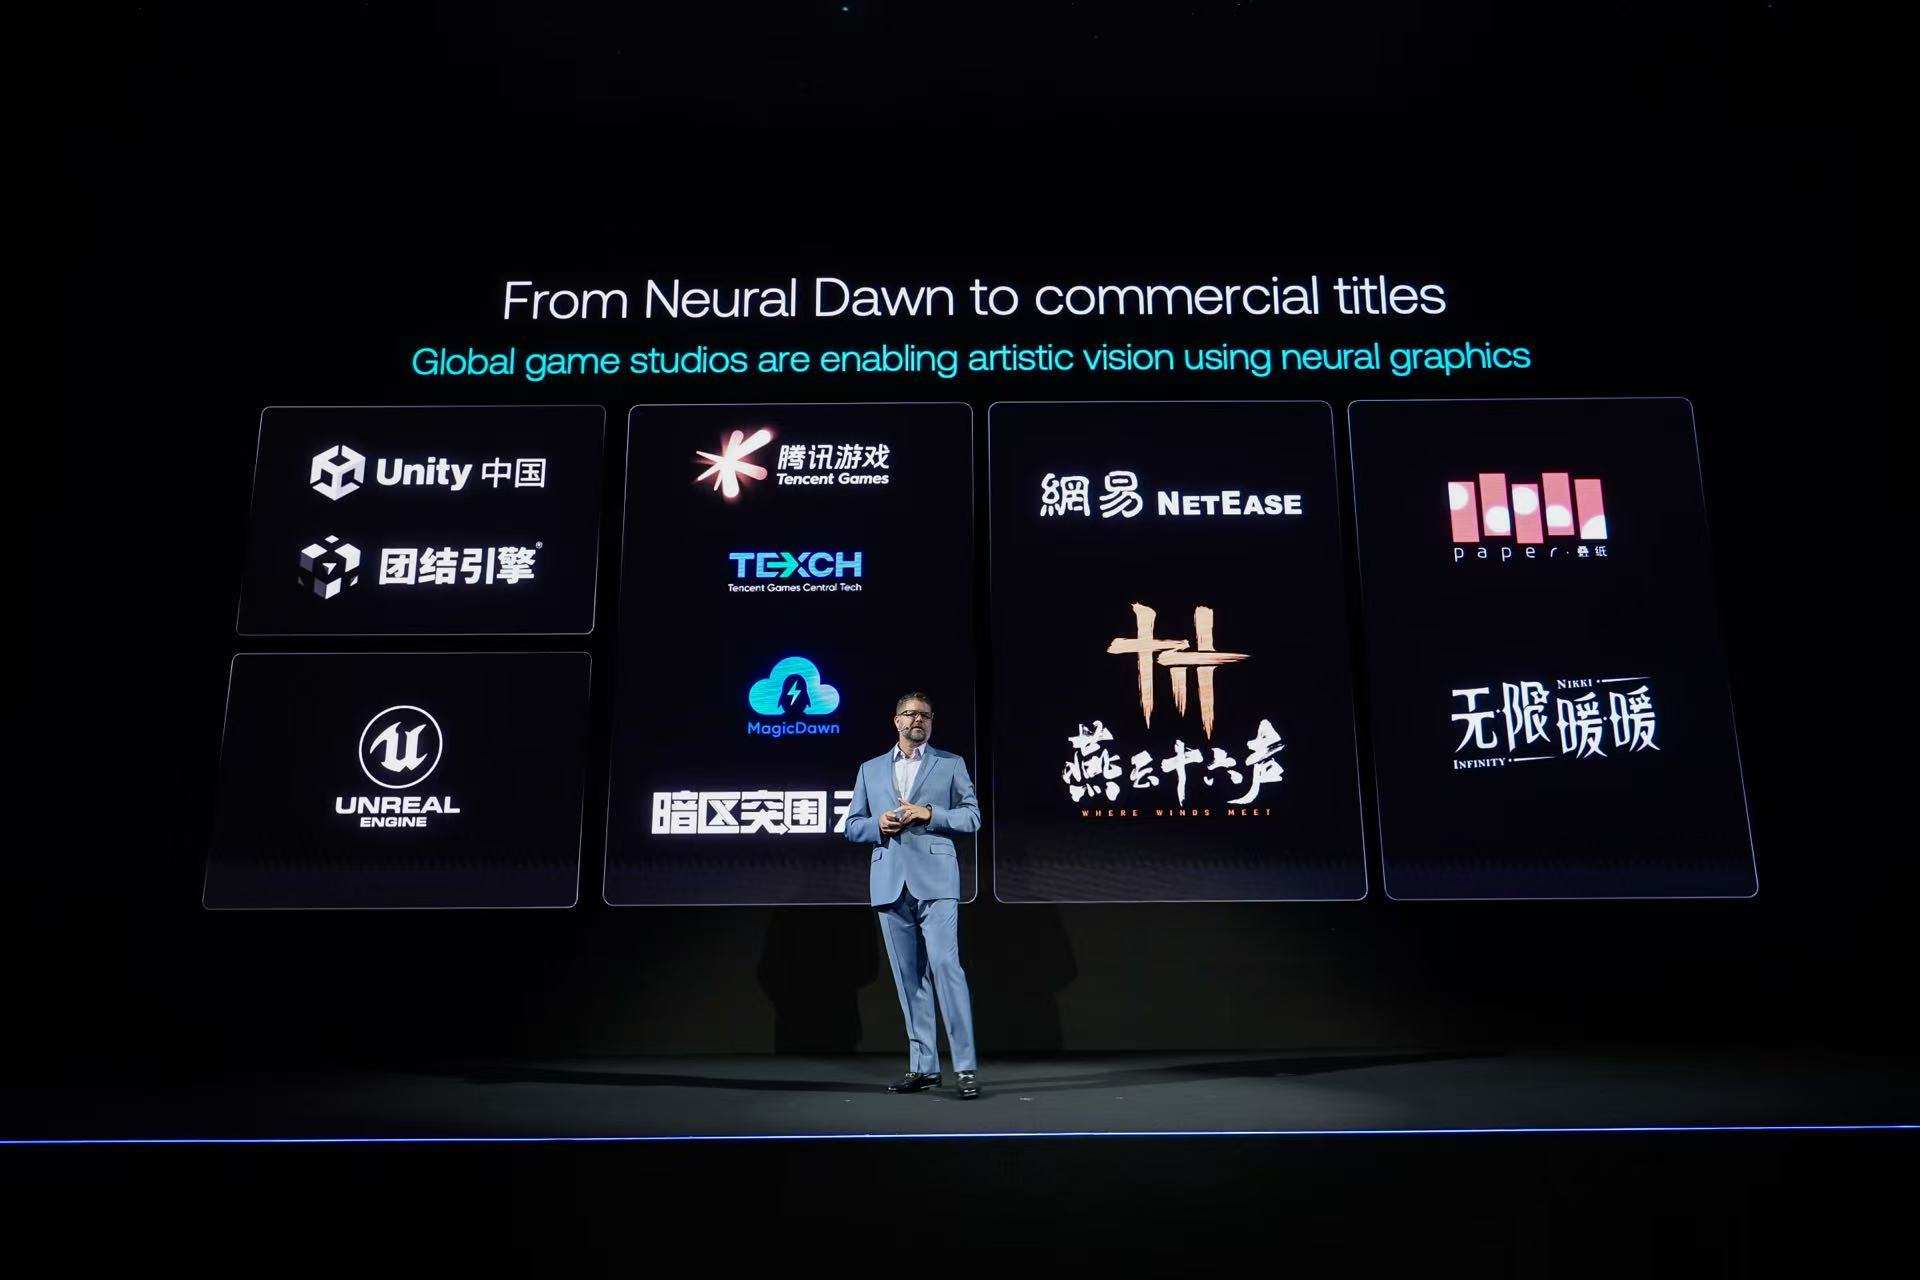
Arm已经推进神经超级采样NSS、神经帧率提升等技术,并与腾讯游戏MagicDawn、Unity中国团结引擎、网易《燕云十六声》、叠纸游戏《无限暖暖》等展开合作。
值得注意的是,Arm 并没有简单复制桌面GPU的路线。
谈到与桌面端多帧生成技术的差距时,Arm表示,移动GPU的核心约束仍然是能效、模型尺寸和散热。现阶段Arm更聚焦单额外帧生成,实现帧率翻倍,未来则会继续向多帧生成、全局照明等方向扩展。这意味着移动GPU与桌面GPU可能越来越使用相似的AI图形技术,但优化目标并不完全相同。
桌面 GPU 可以通过更大的模型和更高功耗换取画质,而移动端首先要解决的是:如何在几瓦功耗和有限内存条件下,把神经图形真正变成可持续运行的功能。
内存越来越贵,AI开始追求“小模型+系统优化”
由于近年来,内存和晶圆成本持续上升。Arm也在与客户共同面对,其解决方式是,让硬件减少内存占用,压缩模型、神经图形和软件优化等。
例如,Arm正与生态伙伴推动更小模型运行,现场特别提到了两比特模型在SME上运行的尝试;腾讯展示的神经纹理压缩,则可以在接近相同画质的情况下显著减少纹理数据量,从而降低内存压力。
这也反映出端侧AI的竞争正在从“模型越大越好”转向另一条路线:在有限算力、有限内存和有限功耗条件下,以更小模型获得足够好的体验。
这可能成为未来智能手机、AI PC乃至机器人的核心工程问题之一。
从CSS到AGI CPU,Arm进一步深入云端
如果说移动端体现的是Arm的系统级AI思路,那么云端则显示了Arm商业边界正在继续扩大。
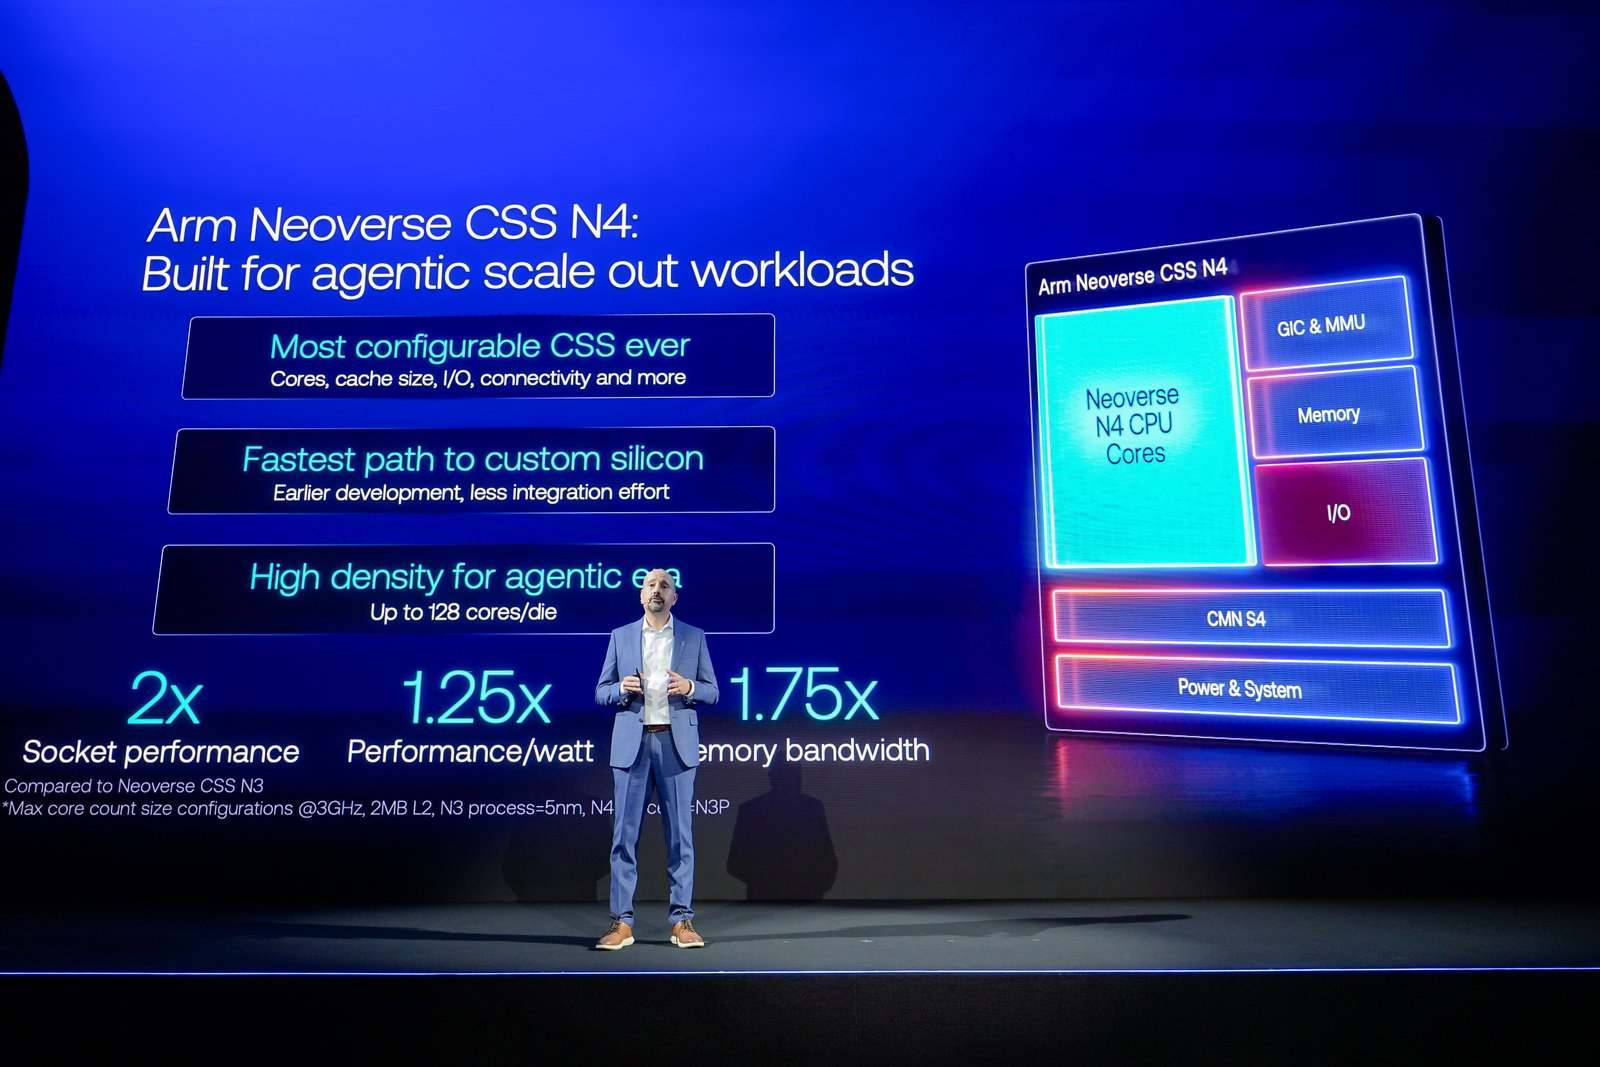
此次 Arm 更新了Neoverse CSS N4。单颗裸片最高支持128个内核,并支持LPDDR6和PCIe Gen 7。相比N3,性能最高可达到两倍,每瓦性能最高提升至1.25倍,内存带宽最高达到1.75倍。
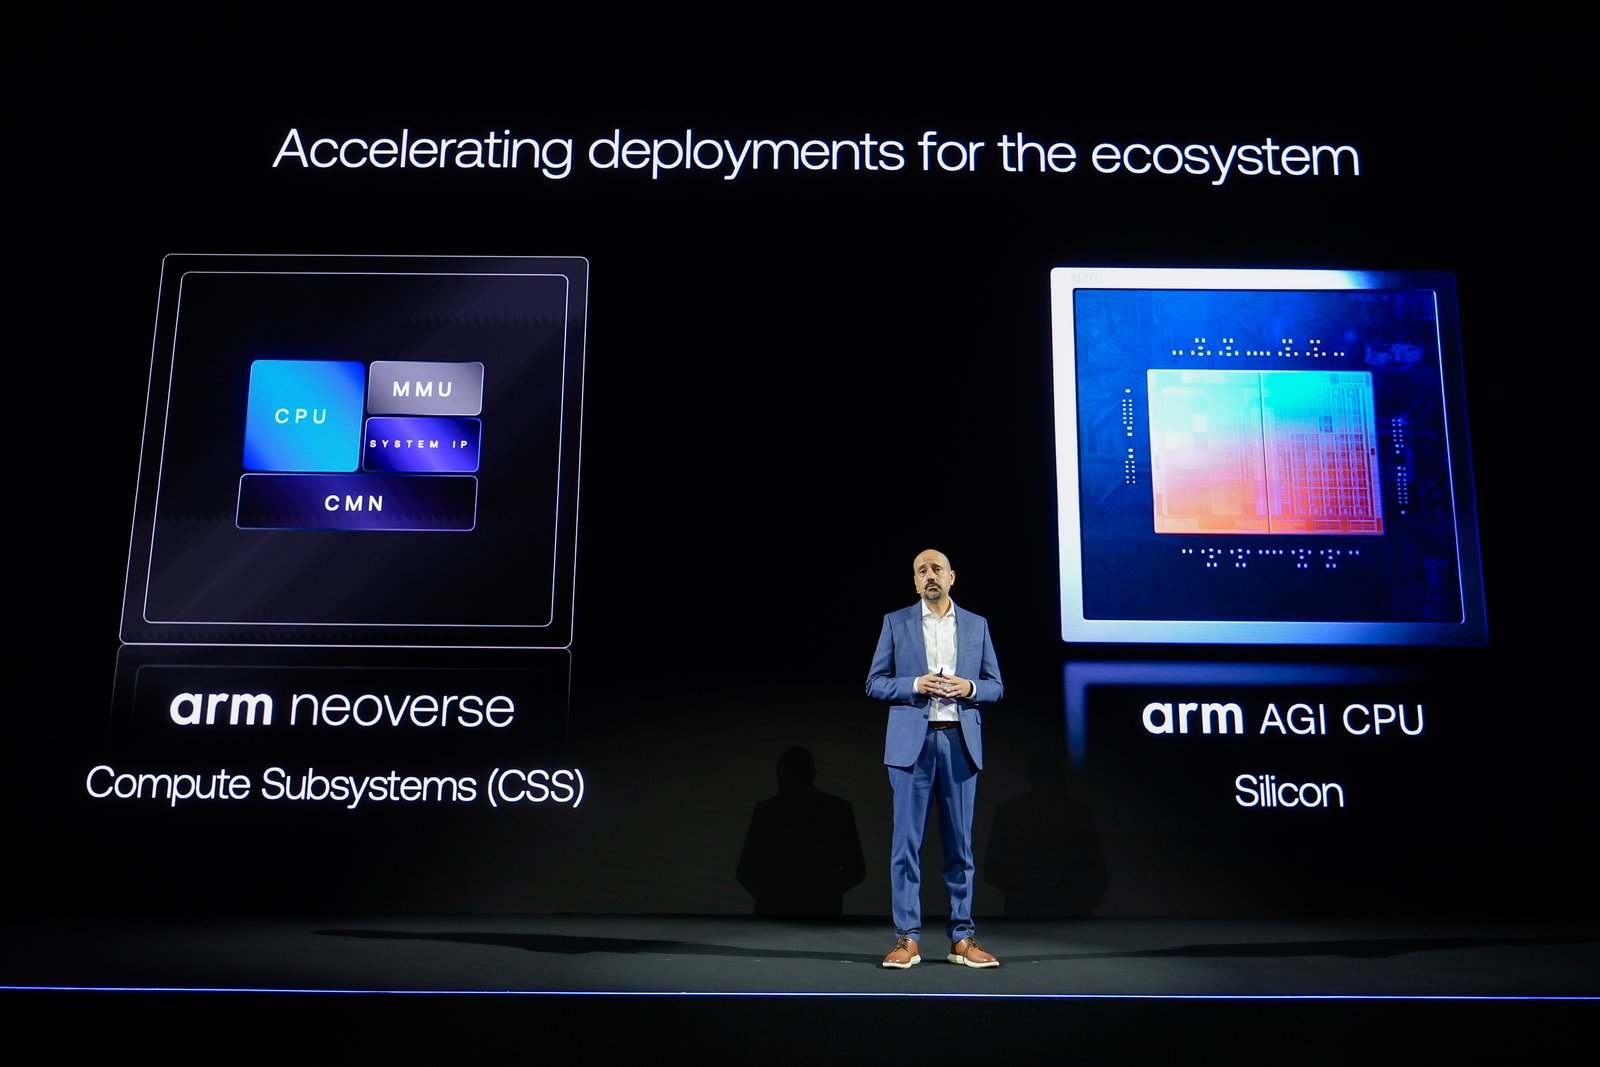
CSS的目的在于帮助客户更快开发自己的芯片。但Arm同时还给出了另一条路径——Arm AGI CPU。
对于希望开发差异化芯片的厂商,可以选择Neoverse CSS;而对于不希望自行完成复杂芯片开发的云服务商或系统厂商,则可以直接采用量产就绪的AGI CPU。
OpenAI、Meta、Oracle、Cloudflare、SAP、联想等企业已经围绕该平台展开相关工作,火山引擎也在推进基于Arm AGI CPU 的智能体沙箱。
为什么智能体时代重新提高了 CPU 的重要性?
因为大量 Agent 工作负载并不是纯粹的大模型矩阵运算。一个智能体需要检索数据、调用工具、运行代码、访问数据库,同时管理大量并发任务。GPU负责模型计算,而CPU则负责大量通用计算和系统调度。
也就是说,AI越来越强,并不意味着CPU被削弱;恰恰可能意味着云端需要更多高效CPU 来支撑智能体运行。
Arm的下一个目标:物理AI
相比移动和数据中心,Arm 在物理AI上也开始布局。
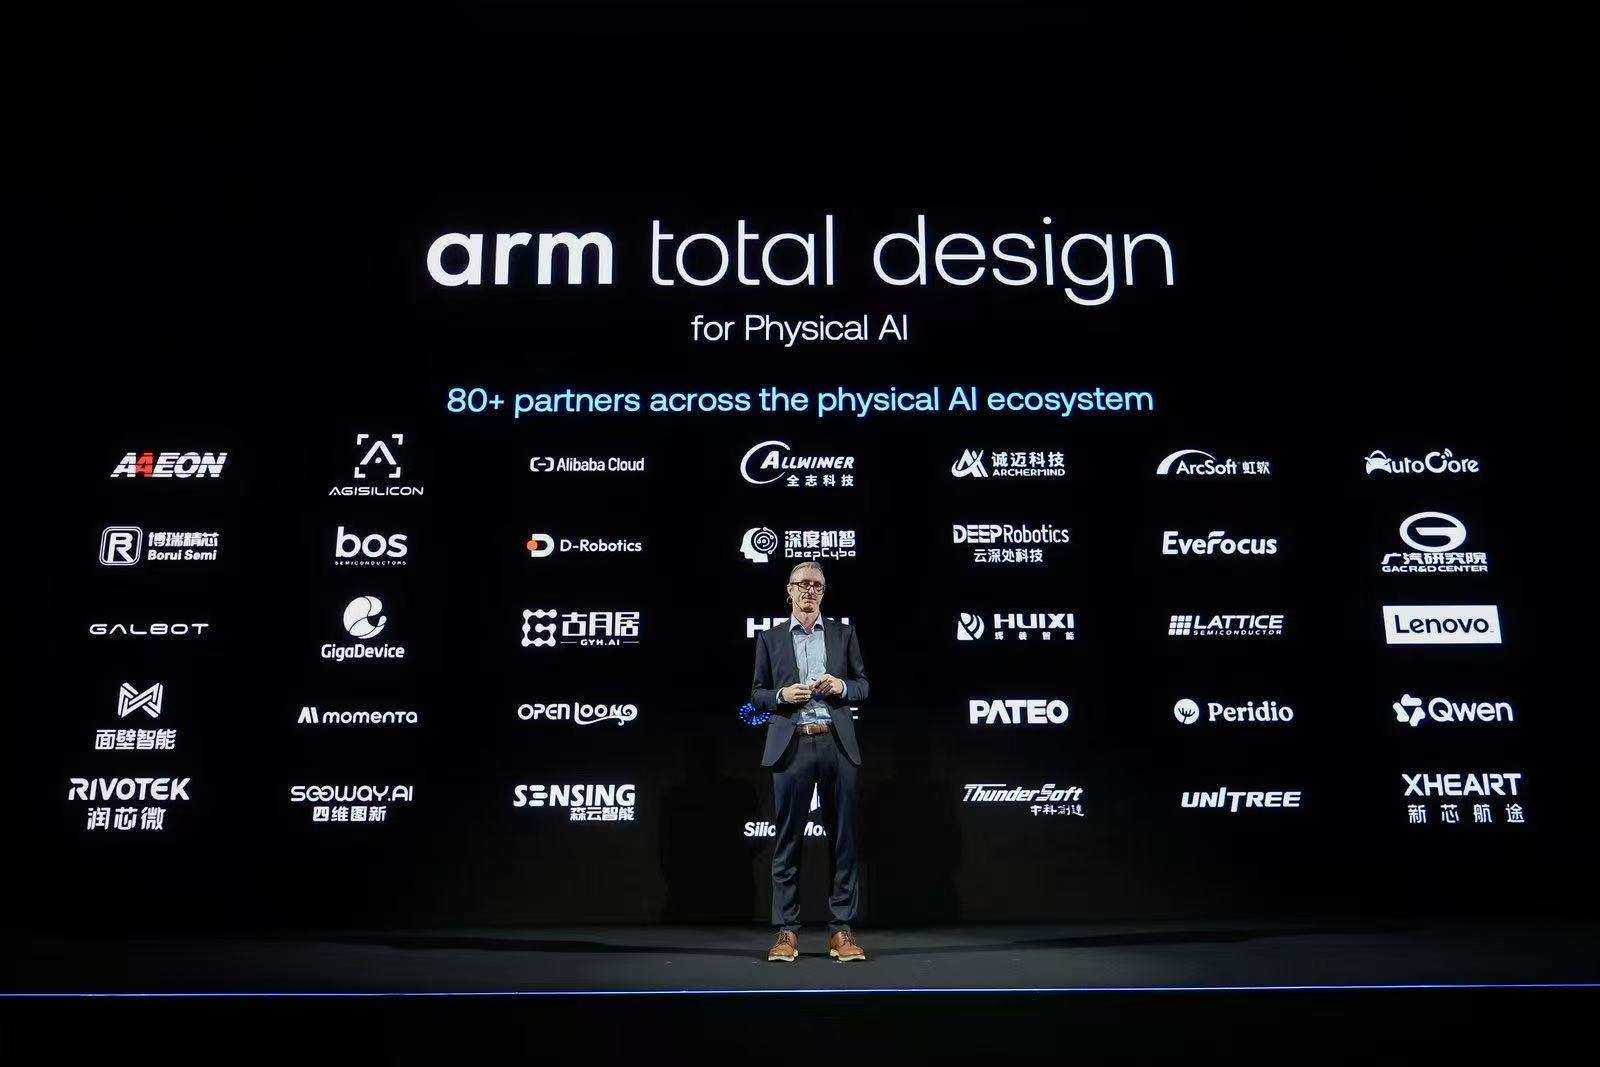
此次Arm将Total Design生态项目正式扩展至物理AI,目前已经吸引 AWS、NXP、Hugging Face、QNX、西门子、通义千问等80多家合作伙伴。
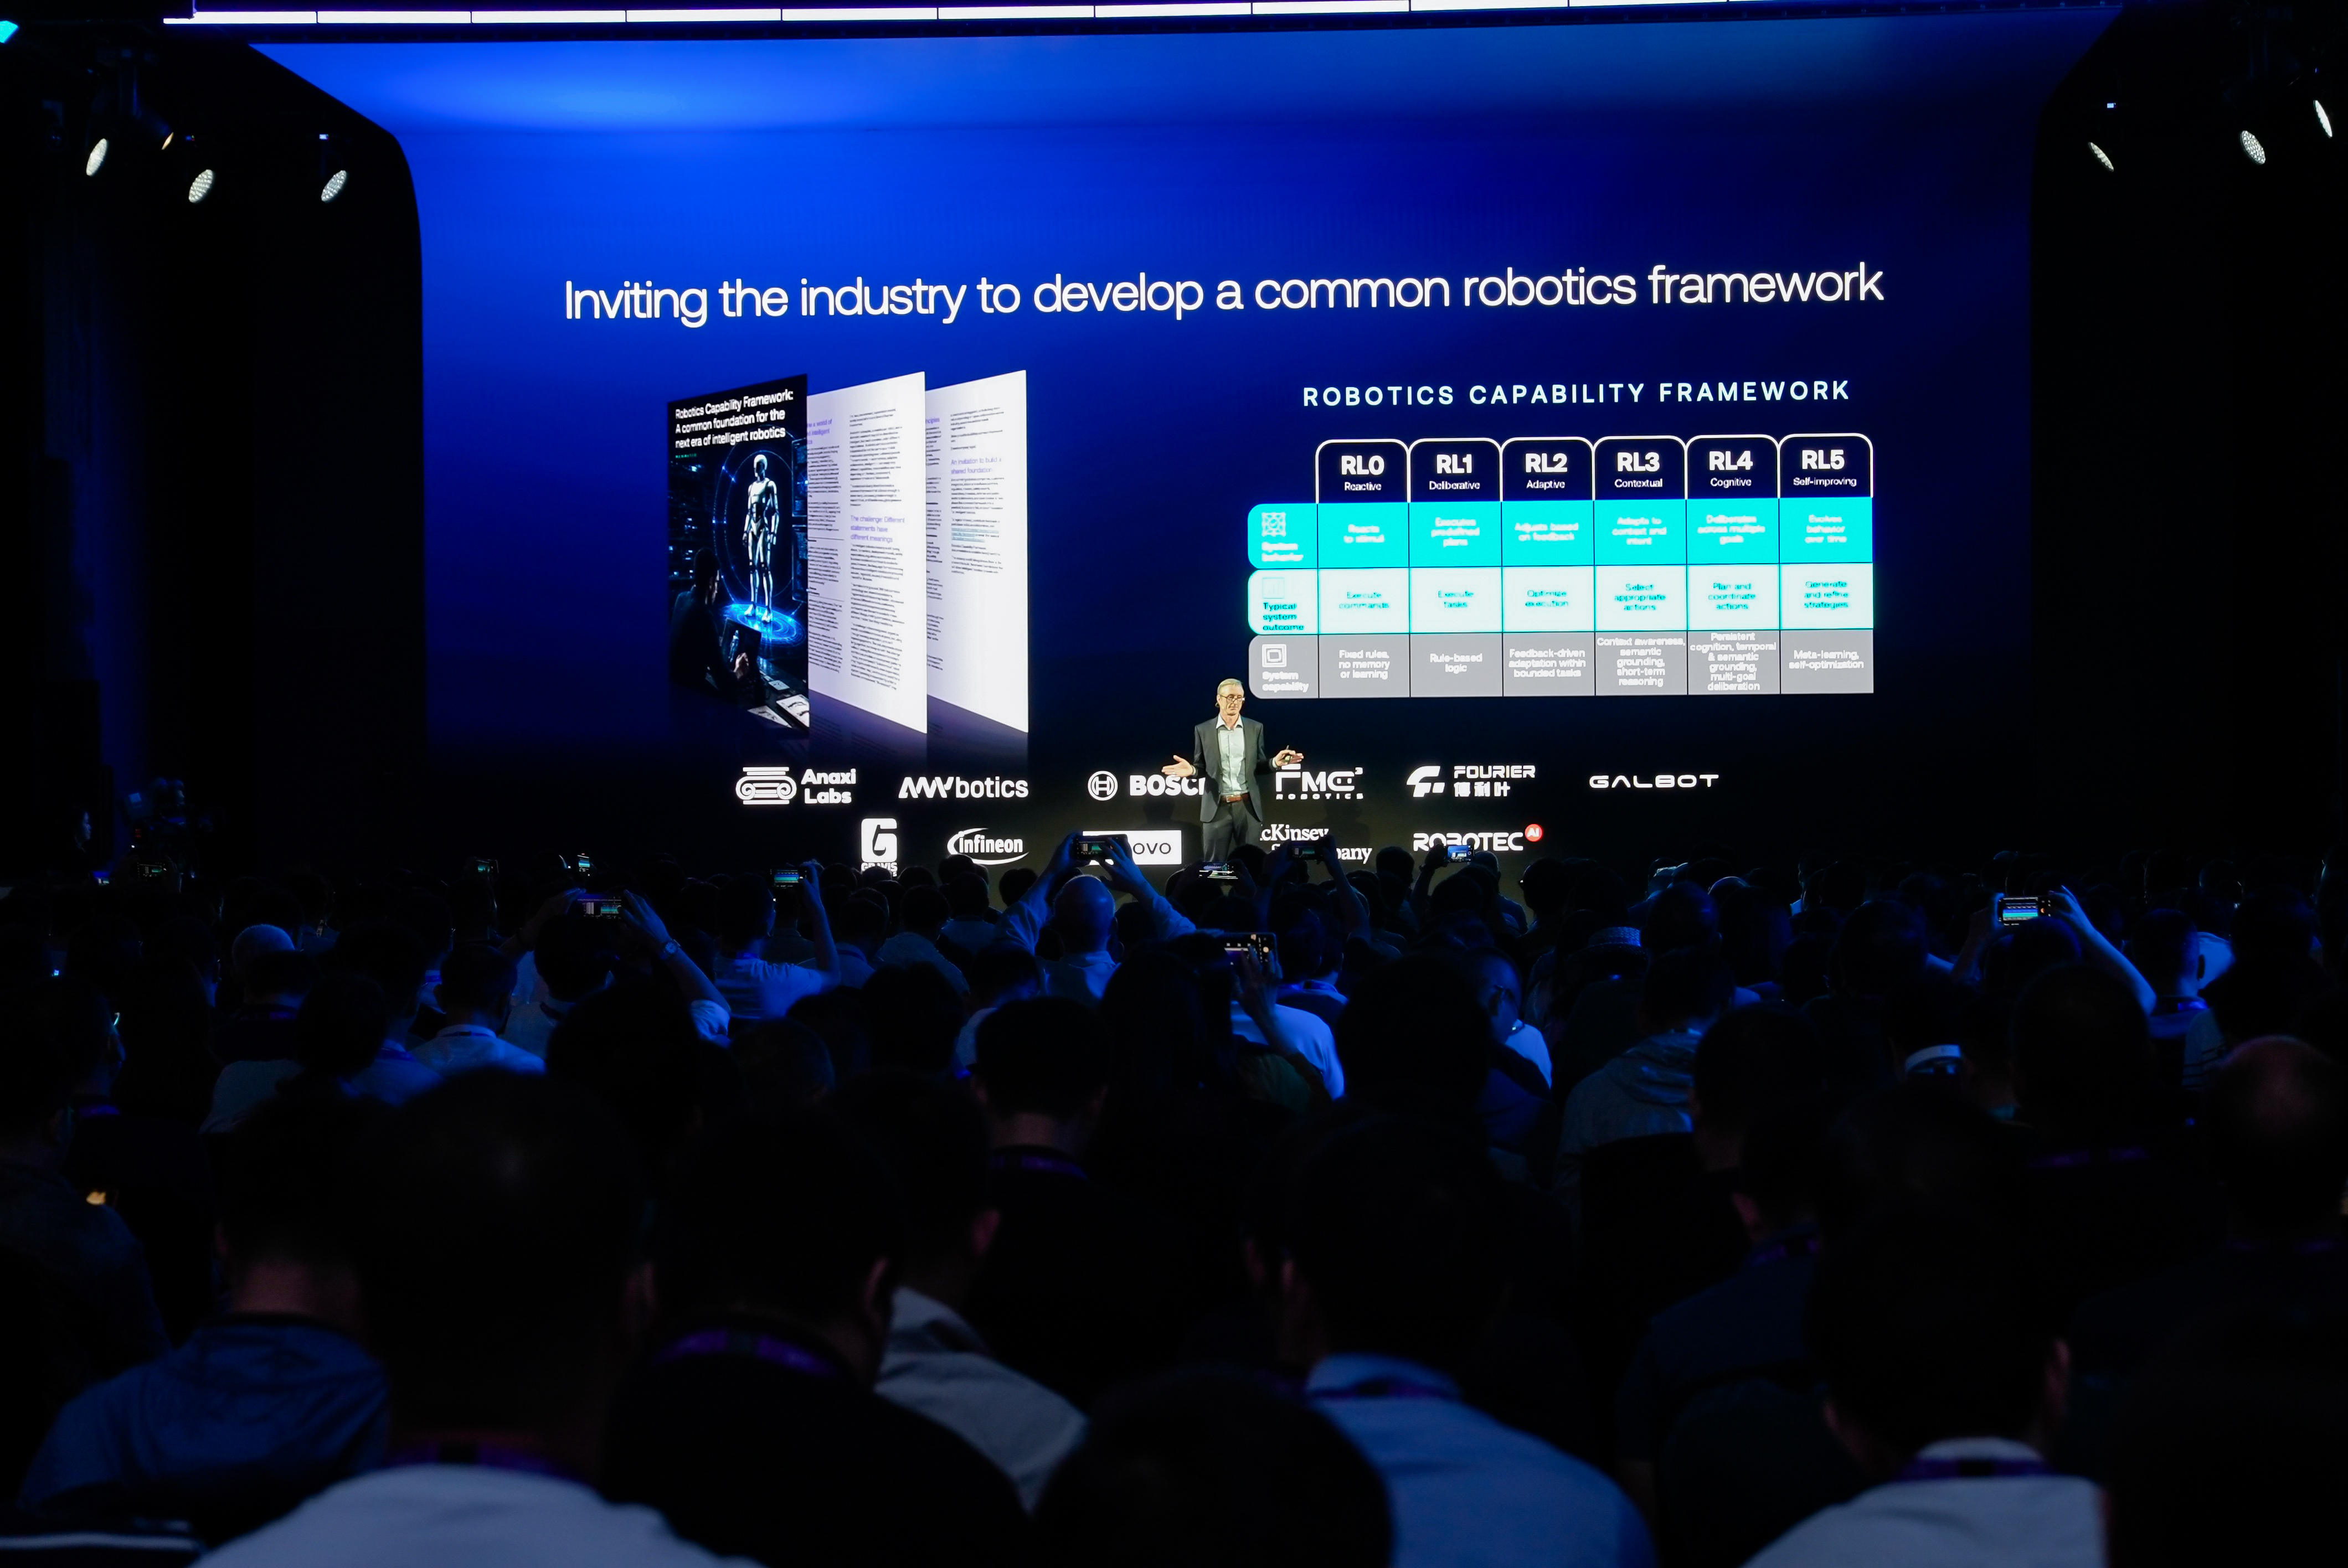
更特别的是,Arm 推出了Robotics Capability Framework——机器人能力分级框架。Arm 希望通过这一框架建立类似自动驾驶 SAE 分级的“共同语言”,将机器人能力与时延、算力部署位置、内存、功耗、确定性和安全等系统要求对应起来。
智能手机时代,Arm最大的优势之一是整个产业围绕统一指令集、工具链和软件生态形成规模效应。
现在Arm显然希望把这种模式进一步复制到汽车和机器人。
当机器人产业仍然高度碎片化时,谁能够连接芯片、操作系统、模型、传感器、数字孪生和开发工具,谁就更有可能占据下一代计算平台的重要位置。
软件正在成为Arm的新战场
因此,Arm Everywhere 的另一条主线其实是软件。
Arm AI Portal正成为连接硬件平台与AI模型的重要入口。开发者可以在其中查找经过Arm 优化的Qwen、Gemma、YOLO等模型,比较延迟、内存占用、模型规模和准确率,并获得代码和部署流程。
更值得注意的是,这个平台不仅面向开发者,也面向AI Agent。
相关资源未来可以通过MCP直接被编程智能体调用。这意味着未来可能不再是开发者自己寻找“这个模型如何在Arm上运行”,而是编程Agent自动完成模型发现、性能比较甚至优化。
从Arm Create所展示的开发流程来看,Arm正把SME2、KleidiAI、Performix、AI Portal、Device Connect和MCP等能力串成一套完整的软件工作流,从模型发现、性能分析,到云端、手机和机器人部署,尽可能保持工具和开发体验的一致性。
结语
目前,Arm全球合作伙伴累计出货的Arm技术芯片已经超过3500亿颗,软件开发者超过2200万。这种庞大的硬件装机基础和软件生态,是Arm进入AI时代最重要的筹码之一。
全部评论