2026年云栖大会上,德明利分享了AI推理场景下的新G2.5存储层级,重点介绍了基于CXL引入PCM等新型介质,构建大容量、低时延内存扩展方案的技术思路。
德明利研发团队将从AI服务器存储分层出发,进一步梳理G2.5层的形成逻辑,并重点解析PCM介质特性、CXL内存扩展路径,以及德明利围绕G2.5层推进的核心芯片与产品化布局。
G2.5层:弥补DRAM与SSD之间“性能断层”
从AI服务器存储分层看G2.5的位置
AI服务器里,数据按照“离计算核心的距离”分层存放:从GPU侧的HBM、主机侧的DRAM,到本地SSD及远端共享存储,越靠近计算核心,访问时延越低、性能越高,但单位容量成本也越高。
在大模型推理过程中,KV Cache也会沿着这一体系逐级分布:活跃、访问频率高的数据优先驻留在HBM中,超出HBM承载能力的部分进一步下沉至DRAM,而访问频率更低的温冷数据,则可以继续下沉至SSD及远端存储。
但现有分层并非连续平滑。G2层DRAM的访问时延处于纳秒级,而G3层NAND SSD则进入微秒级,从几十纳秒到几十微秒,时延相差约三个数量级。为此,行业在DRAM与SSD之间细分出G2.5扩展内存层,通过CXL等技术扩展内存容量,承接仍对时延较为敏感、但无需长期驻留高成本DRAM的数据。
为什么需要G2.5层?
G2.5层的出现,本质上来自AI推理对容量、成本和数据分层提出的新要求:
KV Cache增长带来更大的内存容量压力
通用服务器的内存插槽数量是固定的,单纯依靠增加DRAM已难以持续满足内存扩展需求。
于是,用成本低于DRAM、容量却更大的介质来补充对高性能内存容量的需求,正成为一种趋势。
全部采用DRAM的成本压力持续增加
DRAM虽然具备低时延优势,但单位容量成本较高,大规模扩容会进一步增加系统TCO。
并非所有数据都需要长期驻留DRAM
AI负载本身存在明显的冷、温、热分层,KV Cache也具有一定的访问稀疏性。已有研究和生产实践表明,部分温数据可以从本地DRAM下沉至扩展内存层,在满足访问需求的同时降低对高成本DRAM容量的依赖。
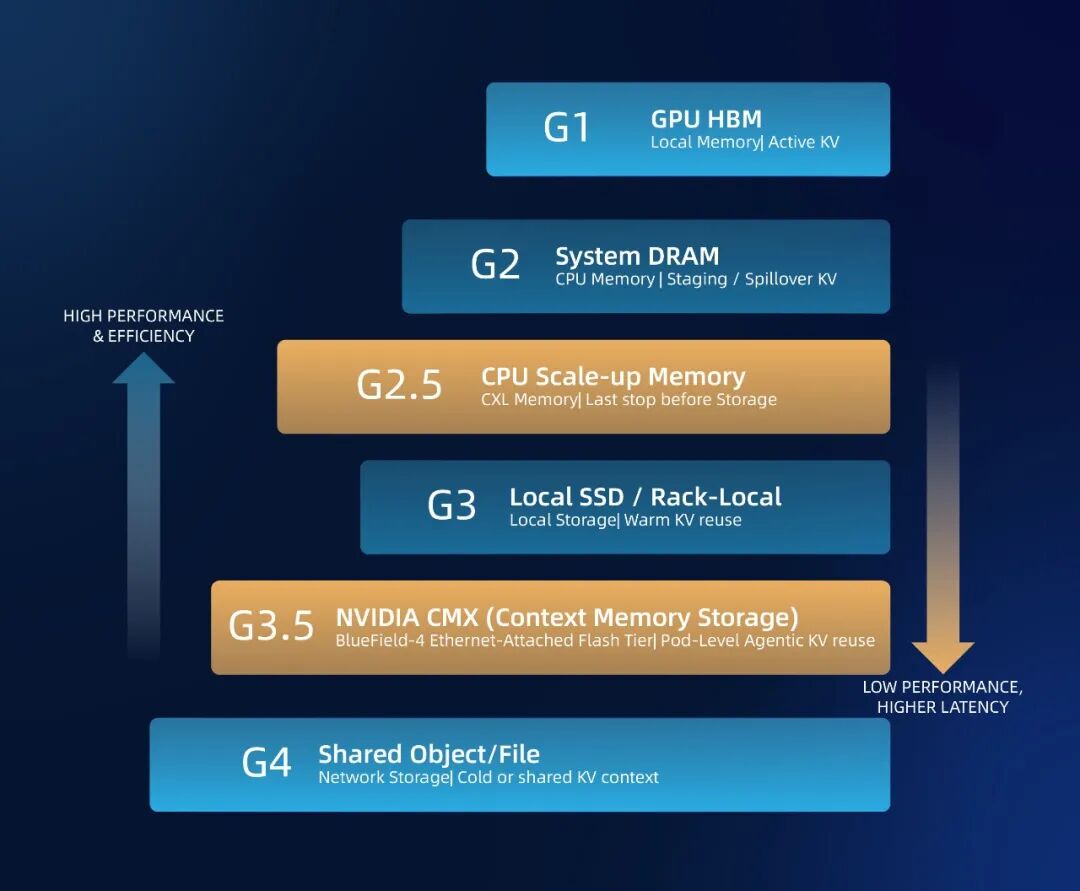
由此,AI服务器的存储体系开始进一步“变厚”。按照数据从热到冷逐级下沉的逻辑,可进一步细分为:
- G1:GPU HBM——承载模型权重及活跃KV Cache;
- G2:System DRAM——承接从HBM溢出的内存数据;
- G2.5:CXL扩展内存——位于DRAM与SSD之间,承载温KV、共享KV等仍需要较低时延访问的数据;
- G3:本地SSD/Rack-local Storage——承载更大容量的温数据及KV复用;
- G3.5:机架级或Pod级闪存层——进一步承载大规模上下文和KV Cache,NVIDIA CMX是代表性架构之一;
- G4:远端共享存储——承载冷数据、长期共享及归档数据。
这其中,G2.5层解决的核心问题,是在DRAM与SSD之间增加一个新的容量和性能选择。
PCM:DRAM与NAND之间的新型存储介质
那么,G2.5层用什么介质来承载?DRAM性能高,但容量扩展成本较高;NAND具备容量和成本优势,但访问时延明显更高。位于两者之间的PCM,为这一新层级提供了新的介质选择。
PCM是什么?
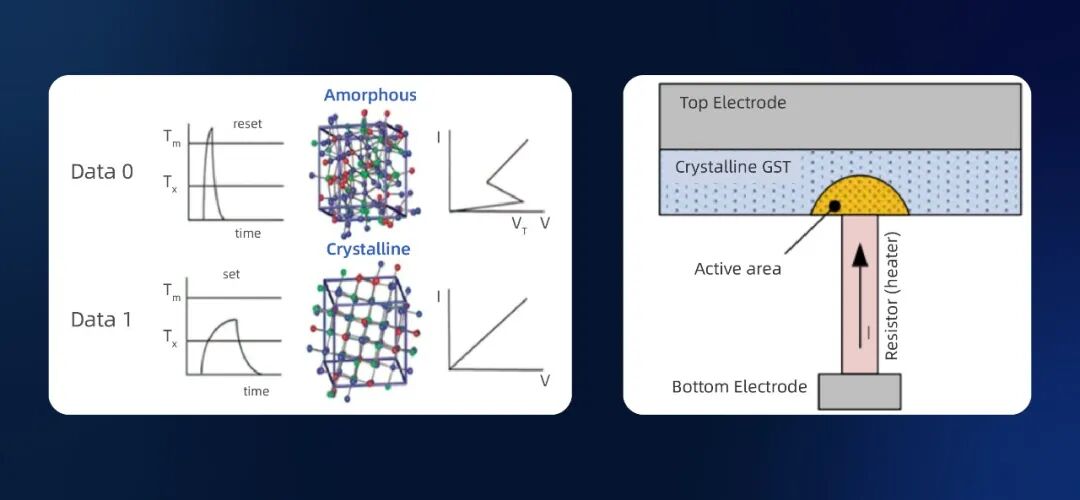
PCM(Phase Change Memory,相变存储器) 是一种非易失性存储介质,通过相变材料在晶态与非晶态之间转换产生的电阻差异来记录数据。由于数据状态由材料本身的物相决定,即使断电后仍可保持,因此天然具备数据持久化能力。
为什么PCM适合G2.5层?
从存储介质分层来看,存储介质一直在沿着"时延阶梯"演进,不同介质本质上是在时延、容量、成本和耐久度之间进行取舍。
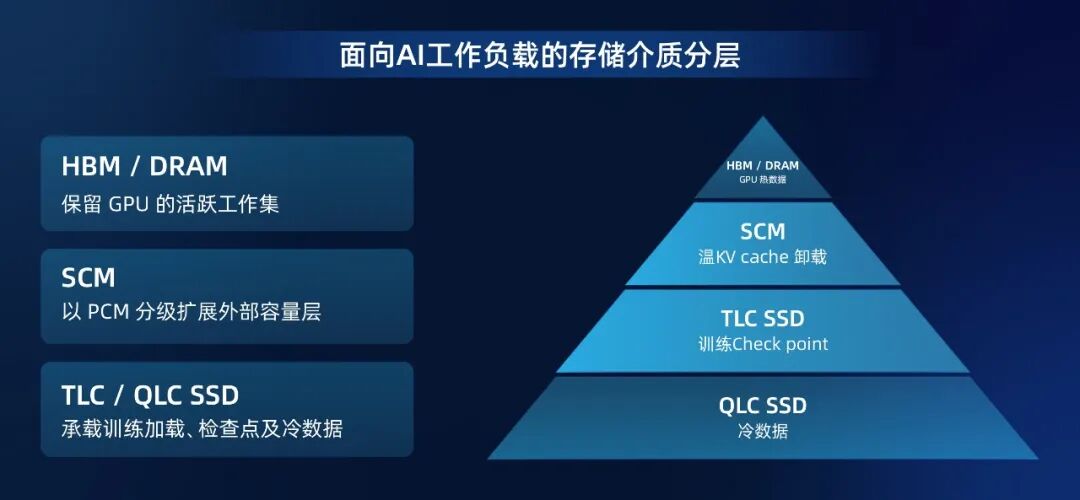
相较NAND Flash,PCM具备更低的读写时延、更高的写入耐久度,并支持更细粒度的数据访问;相较DRAM,则具备非易失性,并在容量密度和单位容量成本方面形成新的扩展空间。
为什么PCM与G2.5层高度匹配?
从量化指标来看,3D PCM相较NAND在访问速度、耐久度等关键维度具有数量级优势;相较DRAM,则在密度和单位容量成本方面形成差异。
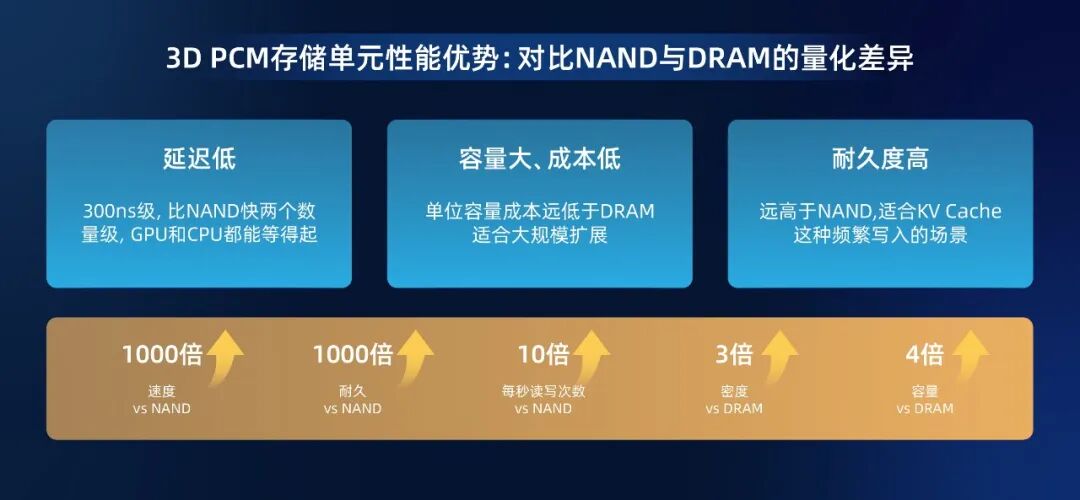
因此,PCM并不是为了替代DRAM或NAND,而是在二者之间提供一种新的介质组合:比NAND更接近内存的性能,同时具备比DRAM更大的容量和成本扩展空间,并兼具数据持久化能力。这与G2.5层所需要的介质特征高度契合。
G2.5存储层如何落地:CXL构建扩展内存
有了合适的介质,还需要解决另一个问题:如何让这部分新增容量以接近内存的方式进入计算系统?
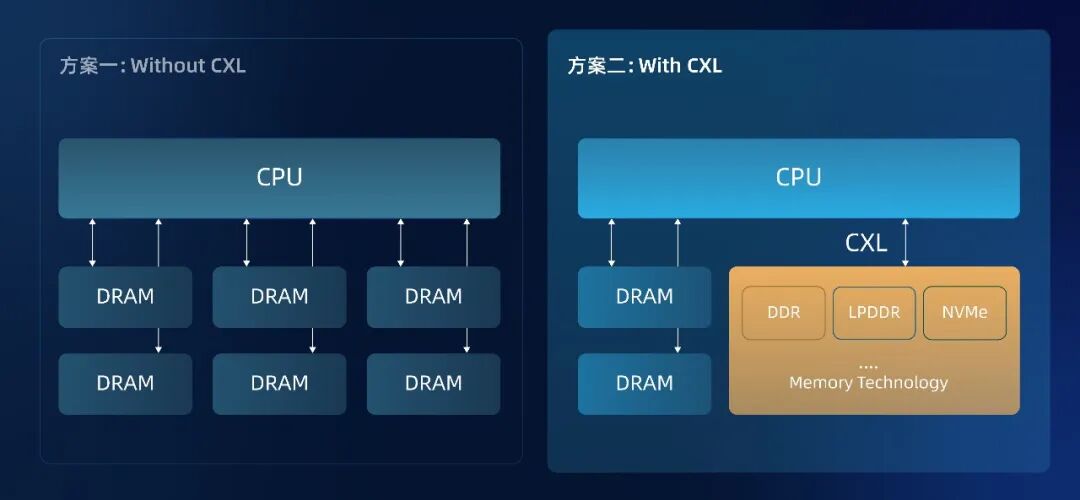
CXL提供了这一技术路径。G2.5层的核心是“扩展内存层”,CXL建立在PCIe物理层之上,通过CXL.mem等协议提供内存语义访问,使CPU可以通过Load/Store方式访问扩展内存,而不再将其作为传统块存储设备处理。也正因此,G2.5不只是“增加一块更快的存储”,而是在系统中增加一个新的内存扩展层。
两种路径:从本地扩展到内存池化
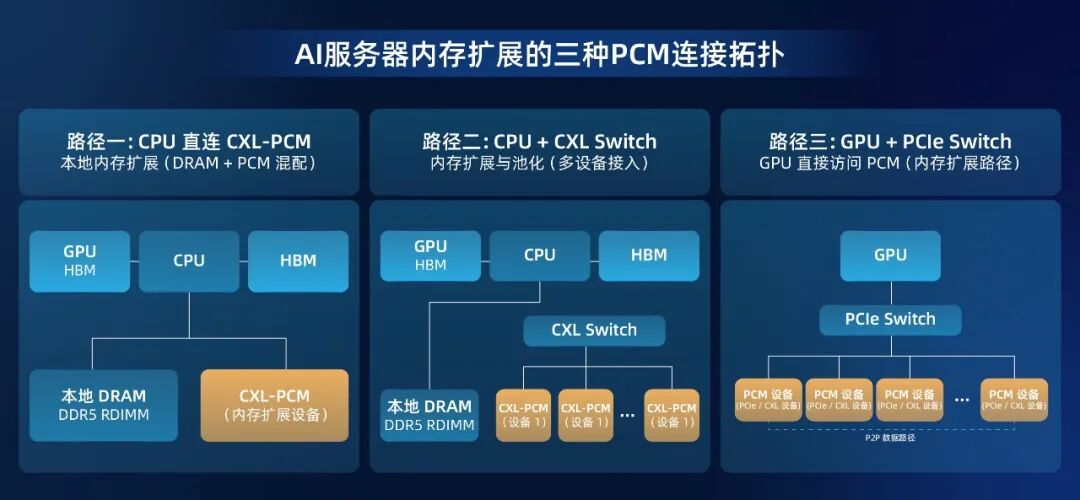
在CXL框架里,G2.5层有三种典型构建方式:
第一种是本地内存扩展
在保留本地RDIMM的基础上,通过CXL将扩展内存(CXL+DRAM或CXL+PCM模组)直接接入CPU,与本地RDIMM共同组成混合内存,这是更偏向单机扩容的路径。实际部署中,可以保留本地DRAM承载高频热数据,再通过CXL外挂PCM扩展更大的内存空间,用于承载容量更大、访问频率相对较低的温数据,从而在性能、容量与成本之间取得平衡。
第二种是内存池化
在本地扩展基础上进一步引入CXL Switch,将多份PCM或DRAM扩展内存组织成共享资源池,由不同CPU节点按需访问和分配,实现从单机容量扩展进一步走向跨主机共享与池化。相比本地扩展,这一路径可以进一步提升内存资源利用率和配置灵活性,但也需要Switch芯片、系统方案、资源调度及生态协同共同支持。
第三种是GPU直连扩展
如支持CXL 扩展的PCIe Switch 将CXL-PCM直连GPU,让GPU可以直接访问扩展内存,减少绕行CPU带来的转发开销与时延,适合大模型推理中GPU显存受限时,直接卸载KV Cache等温数据。
CXL+DRAM与CXL+PCM:两种介质路径
CXL解决的是“扩展内存如何接入系统”的问题,后端采用什么介质,则决定这一层在时延、容量、成本和持久化上的具体特征。目前主要存在CXL + DRAM与CXL + PCM两类技术组合:
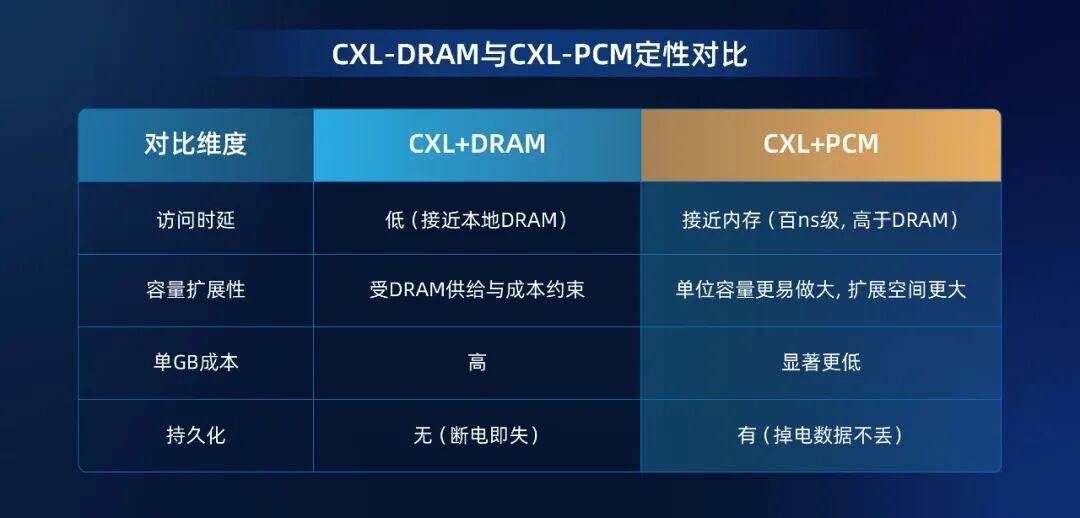
CXL+PCM的意义,并不是替代DRAM,而是与本地DRAM形成新的混合内存配置。
在实际内存部署中,可以保留部分RDIMM承载热数据,同时通过CXL扩展更大容量的PCM空间承载温数据,从而减少全部依靠DRAM扩容带来的成本压力。
方案对比
一个有代表性的混配组合是:在1TB级内存需求下,保留4条128GB RDIMM承载热数据,再配置1条512GB的CXL-PCM扩展剩余容量,热数据留在DRAM中保证性能,温数据下沉至扩展内存,在容量和成本之间形成新的平衡。
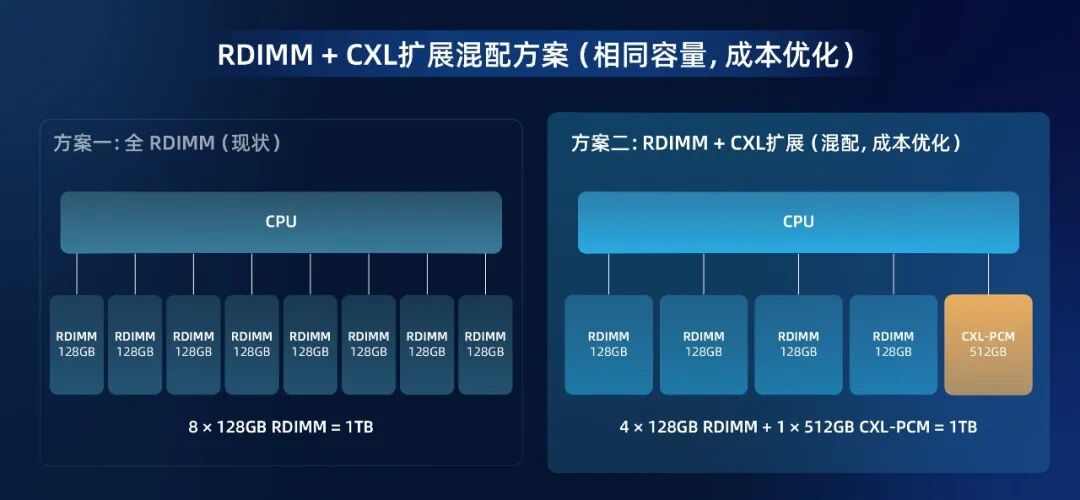
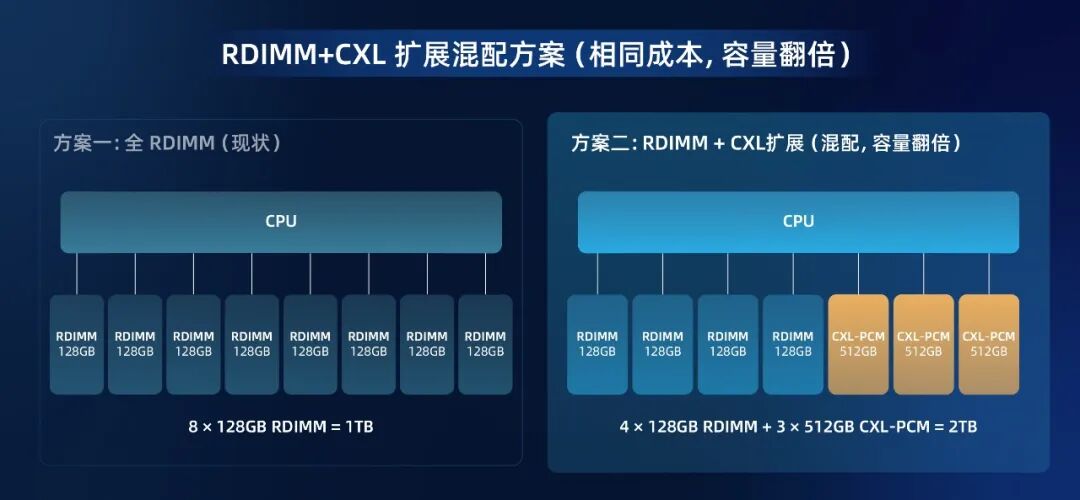
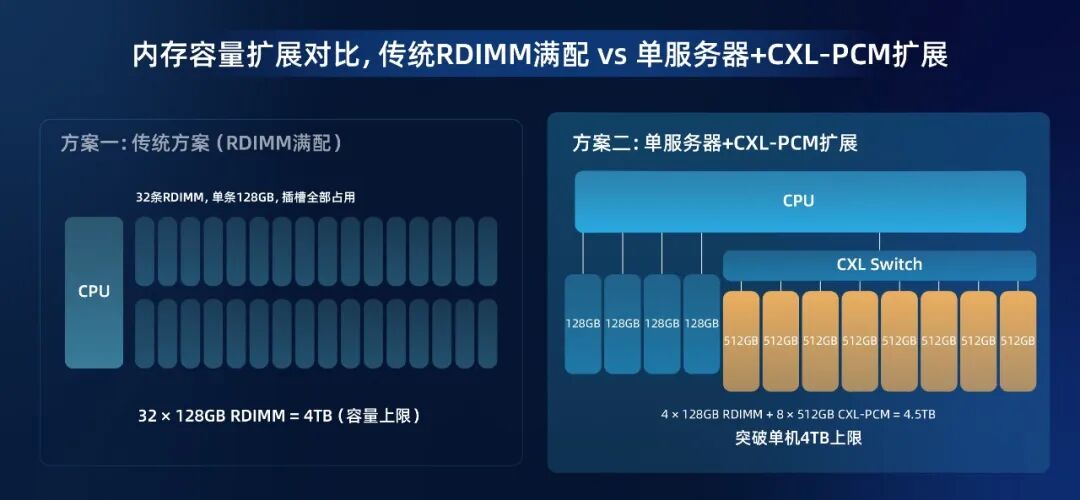
同样,若保留相同的内存采购成本,将二分之一的DRAM成本替换为CXL内存盘,也可以获得更大的整体可用容量。而当DRAM插槽全部占满、单机容量触及上限时,CXL-PCM还能在槽位之外继续扩展——传统32条128GB RDIMM满配为4TB,采用4条128GB RDIMM加8条512GB CXL-PCM即可达到4.5TB,突破单机4TB上限,且预留28条RDIMM 槽位。
德明利推进G2.5层产品化布局
面向G2.5层,德明利正在推进Hima9560 CXL内存扩展主控及相关产品方案,通过CXL连接PCM介质,将持久化内存接入计算系统。
基于Hima9560的相关方案采用E3.S形态,容量覆盖512GB/1TB,读写时延为300+ns级,并支持Load/Store访问及数据持久化,满足AI推理场景下的大容量内存扩展需求。
围绕这一方向,德明利将进一步推进CXL+PCM模组、系统适配及后续内存池化相关布局。从核心芯片、新型介质到系统方案,持续完善面向AI基础设施的分层存储能力。
全部评论